网心技术 | 优先设计好你的 Router
前言
Tunguz 在文中提出了路由的三层结构:Skill Classifier 做意图识别,Router 做调度决策,Model Selector 在层级内比价。Classifier 是语言问题,Router 是调度问题,两者不能混为一谈。他还引用了 Coinbase 的实践:token 用量持续增长,AI 开支却几乎减半,手段是 routing、caching 和 better defaults,不是限制使用。
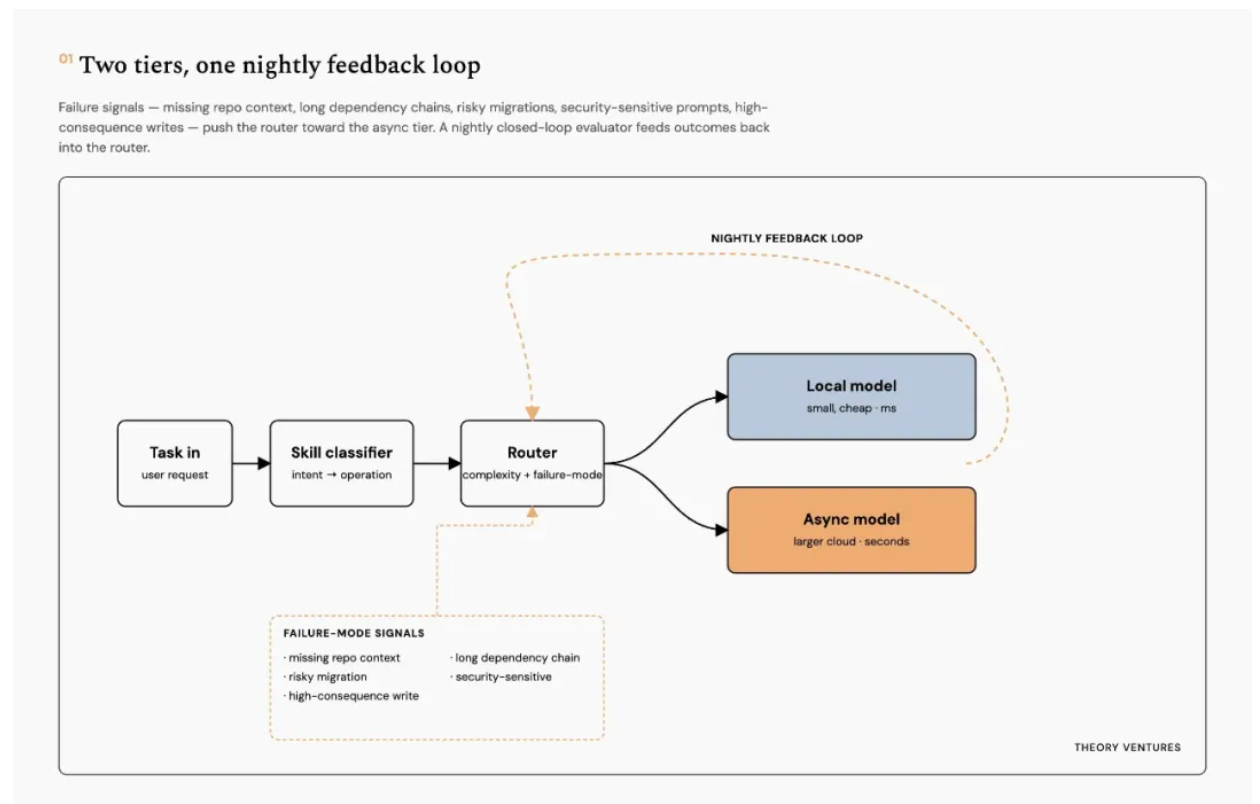
本文以 Tunguz 的这篇文章为起点,结合 2026 年 7 月的定价数据和评测数据,展开三个论点:
- 分工降低成本。这是人类社会验证了几百年的规律,AI 同样适用。
- 大量问题不需要最强模型。当前模型无法自动降低计算复杂度,router 用外部调度替代这个缺失的能力。
- 不同模型擅长不同任务。训练数据和方法的差异导致能力分化,router 把任务导向最擅长的模型。
- 一个团队在启动 AI 项目时,第一个被讨论的问题通常是:"我们用哪个模型?" Claude 还是 GPT?Opus 还是 Sonnet?Gemini 还是 DeepSeek?会议时间大量消耗在模型对比上,路由架构、任务分类、成本分层往往排在后面,甚至不在讨论范围内。这个顺序需要反过来。
一、分工降低成本,这是人类社会验证过的规律
亚当·斯密在《国富论》中描述过一个制针厂。一个工人独立完成全部工序,一天最多做二十枚针。十个人分工协作,每人只做一道工序,一天可以生产四万八千枚针。分工本身降低了社会的整体成本,提升了生产效率。每个人只做自己最擅长的事,整体产出远超个体之和。
这个规律不局限于制造业。律师专注诉讼,会计师专注审计,设计师专注视觉,各自在细分领域积累深度经验。社会整体的专业化程度越高,单位产出的成本越低。这不是某个行业的特例,是组织协作的基本规律。
AI 系统也可以采用同样的逻辑。不同的问题交给不同的模型处理。简单分类用廉价的小模型,复杂推理用旗舰模型,非实时的批量任务走异步通道。这不是降级,是调度。把"所有问题都用最强模型"当作默认策略,等价于让大律师去处理每一份合同审查,让顶级外科医生去量每一次血压。能力过剩的部分不会转化为更好的结果,只会转化为更高的账单。
Coinbase CEO Brian Armstrong 在 2026 年初公开了类似的实践。Coinbase 的 token 用量持续增长,AI 开支却几乎减半。手段不是限制工程师使用 AI,也不是设置支出告警。手段是更好的默认配置、路由策略和缓存机制。工程师仍然可以选择任何模型,默认路由决定了大多数请求的实际去向。这个案例的关键信息是:使用量增长和成本下降可以同时发生。路由不是限制,是优化。
Armstrong 的原话概括了三件事:"not with friction & spend alerts. With better defaults, routing, & caching." 不设摩擦,不设告警,而是设更好的默认值、设路由、设缓存。工程师的自由度不受限,系统的默认行为决定了成本曲线的形状。这是一个值得借鉴的产品哲学:用架构设计替代使用限制。
路由问题有三个层次,每一层做不同的事。三层之间职责清晰,不能混用。
Skill Classifier 把原始用户请求转化为具体操作。它回答的问题是"这个任务是什么"。草拟回复、摘要代码仓库、运行数据库迁移、生成测试用例、审查安全漏洞,这些都是 classifier 输出的标签。Classifier 的输入是自然语言,输出是结构化标签。它是一个语言问题,通常用小模型或规则引擎就能做好。Classifier 本身也可以被路由:简单意图用 Haiku 或 Flash 分类,模糊意图才升级到 Sonnet。
Router 决定哪个层级的模型来执行已分类的操作。它回答的问题是"哪个模型来跑"。Router 不读 prompt 原文。它读 classifier 的标签,再结合复杂度、上下文大小、历史成功率、延迟要求等特征做调度决策。Router 是一个调度问题,不是语言问题。它的决策逻辑可以用加权评分表实现,也可以用机器学习模型训练,核心是对结构化特征做匹配。
Model Selector 在对应层级内选择满足置信度阈值的最便宜模型。同一层级可能有多个候选:production 层有 Sonnet、GPT-5.4、Gemini 3.1 Pro、GLM 5.2、Qwen 3.7 Max 五个选项;budget 层有 Haiku、DeepSeek V4 Pro、Qwen 3.7 Plus 三个选项。Selector 比较它们的实时价格和近期质量表现,选最便宜的达标选项。Selector 是一个经济问题。
Classifier 和 Router 不能混为一谈。把模型选择埋在 prompt 里("如果这个问题很简单,请用简单的方式回答"),就失去了对同一操作 A/B 测试不同模型的能力。把调度逻辑和意图识别绑在一起,系统就无法独立优化每一层。正确的做法是:Classifier 输出标签,Router 读标签做决策,Model Selector 在目标层内比价。三层解耦,各自独立迭代。
用一个具体例子说明三层的协作。用户说:"帮我把上周的销售报告总结一下,重点看华东区的异常数据。"
Classifier 的输出:{operation: "summarize_report", domain: "sales", focus: "anomaly_detection", region: "east_china", timeframe: "last_week"}
Router 读取这个标签,检查特征:操作类型是摘要(历史成功率 98%),上下文大小约 50 页 PDF(中等),无实时性要求(用户没有说"马上"),无风险特征。
Router 的输出:{tier: "async_batch", latency: "within_1h"}
Model Selector 在 async_batch 层选择:Gemini 2.5 Flash($0.30/$2.50)via Batch API,实际价格 $0.15/$1.25。总成本约 $0.02。如果同一请求直接发给 Claude Opus 4.8,成本约 $0.35。17 倍的差距,摘质量没有可感知的差异。
二、大量问题不需要最强模型
当前这一代模型有一个结构性缺陷:它们无法根据问题难度自动降低计算复杂度。 一个"今天星期几"的简单问题和一道需要多步推导的数学证明,在默认配置下消耗相近的算力。模型不会自己判断"这道题太简单了,我用更少的推理步骤就够了"。它只会按收到的问题,倾尽全部参数化能力来生成回答。
这意味着,如果系统把所有请求都发给同一个旗舰模型,成本结构是不优的。大量请求的难度远低于旗舰模型的能力上限,却在按旗舰价格计费。一个典型的 AI 产品,如果观察其流量构成,分类和提取类请求通常占 40% 到 60%,摘要和格式化占 20% 到 30%,真正需要深度推理的不到 20%。这 80% 的请求完全可以在廉价层处理,质量不会有可感知的下降。
价格梯队已经分化
截至 2026 年 7 月,LLM API 市场形成了清晰的价格梯队。各家厂商的定价表可以直接对照:
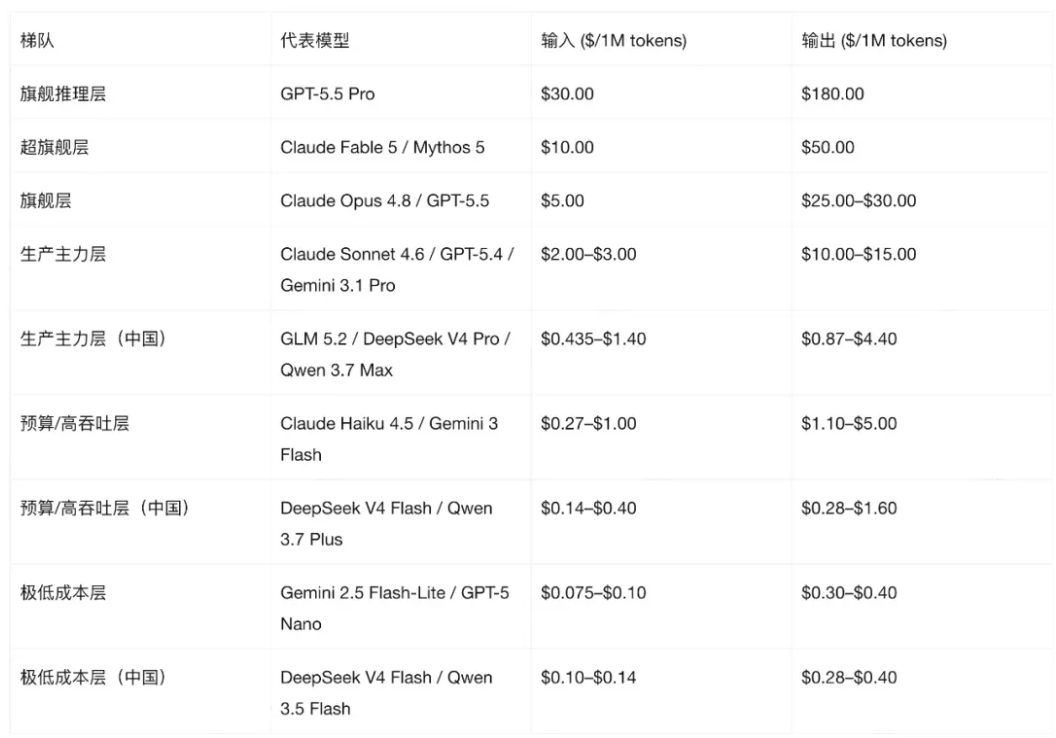
Claude Fable 5 是 Anthropic 在 2026 年 6 月发布的 Mythos 级模型,API 标识为 claude-fable-5。标准定价 $10.00/$50.00,是 Opus 4.8($5.00/$25.00)的两倍。Batch API 定价 $5.00/$25.00,与 Opus 4.8 标准价相同。提示缓存命中价 $1.00/M,为标准输入的 1/10。1M 上下文窗口按标准价计费,单次最大输出 128K tokens。Fable 5 的定价比上一代 Mythos Preview($25.00/$125.00)低了一半以上,能力却更强:SWE-bench Verified 95.0%,SWE-bench Pro 80.3%,均为当前最高。
Fable 5 的定价结构揭示了一个路由要点:能力最强的模型,不一定应该成为默认模型。 Fable 5 比 Opus 4.8 贵一倍,只应在 router 判定为 Tier 3 的高难度编码任务上触发。普通编码任务仍走 Opus 4.8 或 Sonnet 4.6。非实时的复杂编码任务走 Fable 5 Batch API($5.00/$25.00),价格与 Opus 4.8 实时相同,能力却高出 11 个百分点(SWE-bench Pro 80.3% vs 69.2%)。时间换能力,是 Fable 5 最划算的使用方式。
旗舰推理层与极低成本层之间的价差:输入端约 400 倍,输出端约 450 倍。这不是同一产品的不同配置,是不同能力层级之间的结构性价差。
生产主力层($2–$3 输入)在各家定价文档中被定位为"日常生产"的默认选择。CloudZero、APIMart、StackSpend 等第三方定价追踪机构的一致判断是:这一层处理了大多数实际工作负载,质量接近旗舰层,成本约为旗舰层的 1/10 到 1/12。
开源与中国模型重塑路由经济学
2026 年上半年,三家中国厂商的定价策略显著拉低了各层级的价格下限。Router 的层级边界需要随之重新划分。
GLM 5.2(智谱 AI / Z.ai) 于 2026 年 6 月发布,MIT 开源许可,744B MoE 参数,1M 上下文窗口。官方 API 定价:输入 $1.40/M,输出 $4.40/M,缓存输入 $0.26/M。OpenRouter 上最低 $0.91/$2.85。SWE-bench Pro 62.1%,AIME 2026 99.2%,GPQA-Diamond 91.2%,Terminal-Bench 2.1 81.0%。在编码和数学两个维度上,GLM 5.2 的价格约为 Opus 4.8 的 1/6,能力却超过 GPT-5.5。自托管场景下 API 费用为零,只需 GPU 硬件成本。GLM 5.2 是 router 在 production 层和自托管层之间新增的一个强力候选。
DeepSeek V4 Pro / Flash 于 2026 年 4 月发布,1M 上下文,最大输出 384K tokens。V4 Pro 在 2026 年 5 月永久降价 75%,成为正式价格:缓存未命中输入 $0.435/M,缓存命中 $0.003625/M,输出 $0.87/M。V4 Flash:缓存未命中 $0.14/M,缓存命中 $0.0028/M,输出 $0.28/M。缓存命中价几乎为零,对 agent 场景中重复读取代码库上下文的 workload 极为友好。SWE-bench Pro:V4 Pro 55.4%,V4 Flash 未单独公布。DeepSeek 的定价使预算层从 $0.27 下探到 $0.14,极低成本层新增了一个能力远超 Flash-Lite 的选项。
Qwen 3.7 Max / Plus / Flash(阿里巴巴) 构成三层产品线。Qwen 3.7 Max:输入 $1.25/M(限时 50% off,原价 $2.50),输出 $3.75/M,1M 上下文,SWE-bench Pro 60.6%,AIME 2026 97.0%,定位 agent 长程执行。Qwen 3.7 Plus:输入 $0.40/M,输出 $1.60/M,支持多模态视觉输入,适合 GUI agent 和屏幕交互场景。Qwen 3.5 Flash:输入 $0.10/M,输出 $0.40/M,1M 上下文,与 Gemini Flash-Lite 价格相当。Qwen 3.7 Max 在过去 90 天内价格下降 50%,从 $2.50 降至 $1.25,趋势仍在继续。
三家模型的共同特征是:生产主力层价格从 $2–$3 下探到 $1.25–$1.40,预算层从 $0.27–$1.00 下探到 $0.14–$0.435,极低成本层维持在 $0.10–$0.14。Router 在每个层级内的候选模型数量从 2–3 个扩展到 5–8 个,Model Selector 的比价空间显著增大。GLM 5.2 的 MIT 许可 + SWE-bench Pro 62.1% 组合,为自托管编码场景提供了一个此前不存在的选项:开源模型首次在硬编码评测上超过 GPT-5.5。
算一笔具体的账
假设一个中型 AI 产品,每天处理 10 万次 API 调用,平均每次 2000 input tokens + 500 output tokens。
全部走 Claude Opus 4.8($5/$25):
- 日输入成本:100,000 × 2,000 / 1,000,000 × $5 = $1,000
- 日输出成本:100,000 × 500 / 1,000,000 × $25 = $1,250
- 日总成本:$2,250,月总成本约 $67,500
路由后(60% Flash-Lite,30% Sonnet,10% Opus):
- Flash-Lite 部分:60,000 × (2,000 × $0.10 + 500 × $0.40) / 1,000,000 = $24
- Sonnet 部分:30,000 × (2,000 × $3 + 500 × $15) / 1,000,000 = $405
- Opus 部分:10,000 × (2,000 × $5 + 500 × $25) / 1,000,000 = $225
- 日总成本:$654,月总成本约 $19,620
路由后的月成本是全部走 Opus 的 29%。质量方面,60% 的分类和提取请求在 Flash-Lite 上的准确率与 Opus 无显著差异,30% 的生产任务在 Sonnet 上与 Opus 质量接近,只有 10% 真正需要 Opus 的深度能力。这不是理论推演,是 Tom Tunguz 和 Coinbase 在实践中验证过的成本结构。
哪些任务真的不需要旗舰模型
把 AI 产品的请求按难度分层,可以得到一个粗略但实用的分布:
Tier 0(约 40%–50%):格式转换、字段提取、意图分类、关键词匹配。 输入和输出都是结构化的,模型只需要模式识别,不需要推理。Haiku、Flash-Lite、DeepSeek V4 Flash、Qwen 3.5 Flash 足够。错误率通常低于 2%。
Tier 1(约 20%–30%):摘要、翻译、简单问答、模板填充、代码格式化。 需要一定的语言理解能力,不需要深度推理。Sonnet、GPT-5.4、GLM 5.2、Qwen 3.7 Max 足够。这些任务在 MMLU 级别以下的认知负荷,主力层模型完全覆盖。
Tier 2(约 10%–15%):多步分析、跨文件代码修改、复杂文档理解、方案设计。 需要深度推理和全局上下文。Opus、GPT-5.5、GLM 5.2、Qwen 3.7 Max、Gemini Pro + Deep Think 才合适。
Tier 3(约 5%):数学证明、安全审计、架构决策、高后果操作、跨十文件以上的复杂编码。 需要推理专用模型或顶级编码模型。o3 系列、Claude extended thinking、Claude Fable 5($10/$50)、人工 in the loop。这一层的请求数量最少,单次成本最高,质量要求最严。
Tier 0 和 Tier 1 合计占 60% 到 80% 的流量。这些请求用 $0.10/M 的模型和 $5.00/M 的模型,输出质量对用户不可区分。Router 的核心工作,就是把 Tier 0 和 Tier 1 从 Tier 2 和 Tier 3 中分离出来,送往正确的价格层级。
提示缓存进一步压缩成本
各家 API 都提供了 prompt caching 机制。Anthropic 的 cached input 价格为标准输入的 1/10(Sonnet cached $0.30/M vs 标准 $3.00/M)。OpenAI 的 cached input 为标准的 1/5。对于 agent 场景中大量重复的系统 prompt、工具定义、代码库上下文,缓存可以削减 50% 到 90% 的输入成本。
Coinbase 的路由策略中,caching 是与 routing 并列的核心杠杆。两者叠加的效果是:路由决定"用什么模型",缓存决定"重复的部分不再计费"。
异步批处理:时间换金钱
价格梯队解决的是"用什么模型"的问题。异步批处理解决的是"什么时候算"的问题。
OpenAI Batch API 对所有模型提供 50% 折扣,换取 24 小时内的完成时间。GPT-5.4 从 $2.50/$15.00 降至 $1.25/$7.50。批处理与提示缓存叠加使用时,总节省可达 75%。实际运行中,多数批处理在 1 到 6 小时内完成,远低于 24 小时的 SLA 上限。
异步推理与实时推理之间的成本差距,据 Tom Tunguz 引用的数据,可达两个数量级。TokenMix 的追踪数据显示,团队将至少一半工作负载迁移到 Batch API 后,月 API 总开支下降 35% 到 48%。这不是边际优化,是架构层面的成本杠杆。批处理通道与实时通道并列,应该成为 router 的标准输出选项之一。
不是所有问题都需要实时响应
草稿生成、代码仓库摘要、尽调备忘录、夜间评估跑批、批量数据标注、历史日志分析,这些工作不需要在一秒内返回结果。用户提交请求后可以去做别的事,系统排队处理,结果稍后送达。
排队本身就是一种路由策略。它把"实时"和"异步"分成两条执行通道,每条通道绑定不同的成本结构。这与人类社会的工作节奏一致。不是每封邮件都需要秒回,不是每个任务都标为紧急。紧急的走快车道,可以等待的走慢车道,慢车道更便宜。
Tom Tunguz 的判断是:一旦系统具备排队能力,需要实时回答的工作占比会低得令人惊讶。问题从"选哪个模型"收窄为"多大比例的工作需要实时答案"。对于 agent 系统,这个比例通常在 20% 到 30% 之间。其余 70% 到 80% 的工作,要么可以异步处理,要么可以用更便宜的模型处理,要么两者兼而有之。
输出 token 是隐藏的成本杠杆
各家 API 的定价结构中,输出 token 通常比输入 token 贵 4 到 6 倍。Claude Opus 4.8 的输入 $5.00/M,输出 $25.00/M,倍率 5 倍。GPT-5.5 Pro 的输入 $30.00/M,输出 $180.00/M,倍率 6 倍。
对于生成密集型任务(长回答、代码生成、报告撰写),输出成本往往占总成本的 60% 到 80%。Router 在选择模型时,不仅要考虑输入价格,还要考虑该模型在该操作类型上的输出长度。GPT 在 agent 循环中输出 token 比 Claude 少 72%,这意味着即使 GPT 的单价与 Claude 相同,实际账单也低得多。
StackSpend 2026 年 7 月的分析指出:"The output column is the one to optimize." 输出优化是路由策略中经常被忽视的一环。对于可以控制输出长度的操作(JSON 结构化输出、固定格式摘要、有模板约束的生成),在 router 层标注 max_output_tokens 和 output_format,可以显著压缩输出成本。
三、不同模型擅长不同任务
成本优化只解决了一半问题。另一半是质量。由于训练数据、训练方法和架构设计的差异,各家模型在不同任务上形成了明确的能力分化。2026 年的评测数据不支持"存在一个全能冠军"的假设。PanelsAI 的总结很直接:"Claude 3.5 Sonnet 在写作质量和软件工程上领先,GPT-4o 在多模态和广度上领先,o1 在数学推理上领先,Gemini 1.5 Pro 拥有最佳上下文窗口和 Google Workspace 集成。" 四个"领先",四个不同维度,没有一个"全面领先"。
编码:Claude 在复杂工程上领先
SWE-bench Pro 是比 SWE-bench Verified 更严格的编码评测。它测试模型在真实多文件代码库中实现功能、通过测试、不破坏已有逻辑的能力。2026 年 6 月的数据:
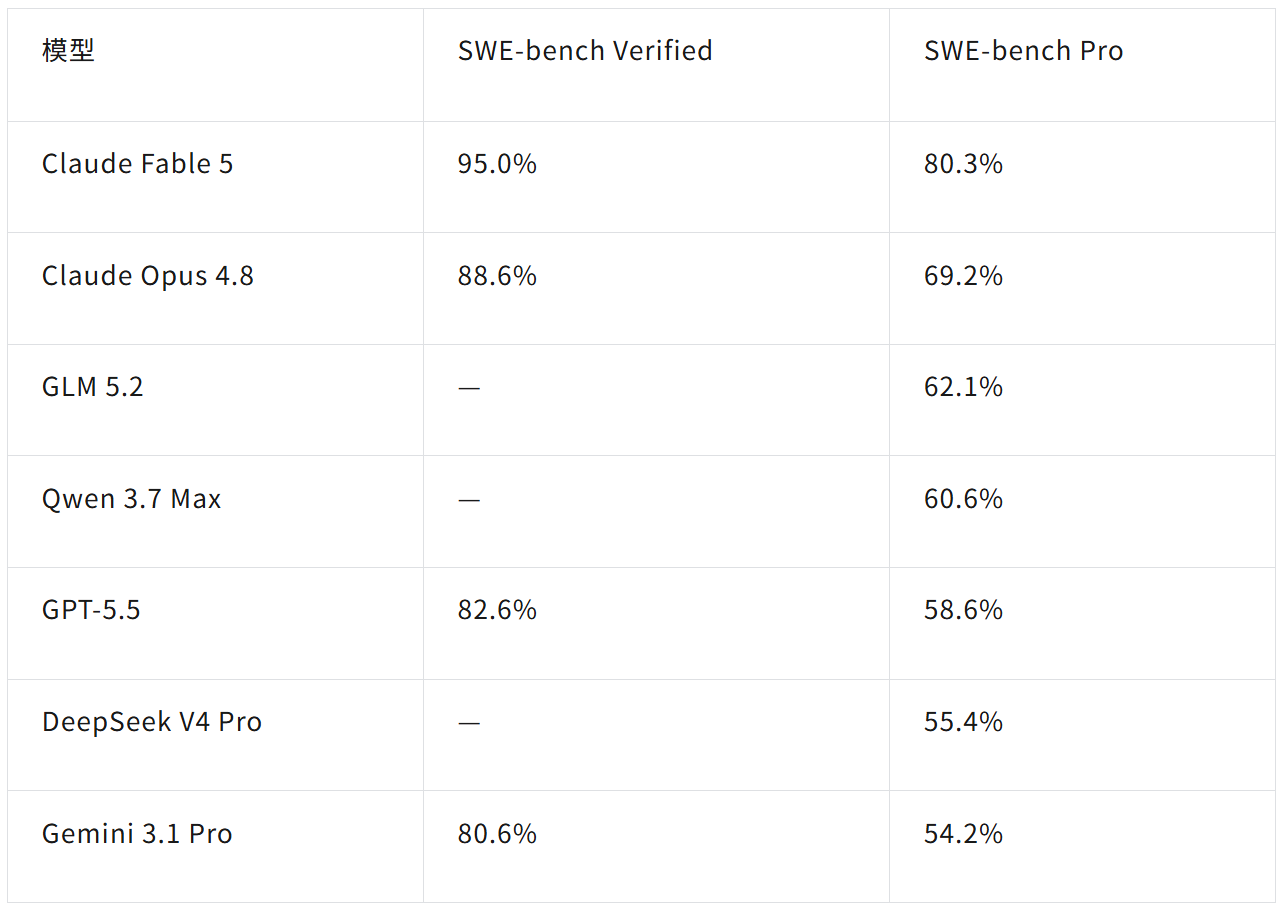
从 Verified 到 Pro,Gemini 从 80.6% 跌到 54.2%,跌幅 26.4 个百分点。Claude Opus 从 88.6% 到 69.2%,跌幅 19.4 个百分点。Claude Fable 5 从 95.0% 到 80.3%,跌幅 14.7 个百分点,是三家旗舰中抗难度提升能力最强的。评测难度提升后,模型之间的分化加剧,不是缩小。Fable 5 在 SWE-bench Pro 上领先 Opus 4.8 达 11.1 个百分点,领先 GPT-5.5 达 21.7 个百分点。
GLM 5.2 以 62.1% 位列开源模型第一,超过 GPT-5.5(58.6%)和 Qwen 3.7 Max(60.6%)。这是开源模型首次在 SWE-bench Pro 上超过 GPT-5.5。GLM 5.2 采用 MIT 许可,744B MoE 参数,1M 上下文窗口,API 定价 $1.40/$4.40,约为 Opus 4.8 的 1/6。DeepSeek V4 Pro 以 55.4% 排在预算层,定价 $0.435/$0.87,永久 75% 降价后成为正式价格。
Fable 5 的能力溢价有明确的价格标签:实时 API $10.00/$50.00,是 Opus 4.8 的两倍。Router 应把 Fable 5 限定在"一次失败代价极高"的编码任务上,比如跨十个以上文件的重构、高风险数据库迁移、安全审计代码审查。其余编码任务由 Opus 4.8 或 Sonnet 4.6 承担,成本减半,质量差距在大多数场景下不可感知。
Terminal-Bench 2.0 测试 agentic 命令行操作能力。Claude Opus 约 90%,GPT-5.5 为 82.7%,Gemini 3.1 Pro 为 80.2%。在需要多步工具调用、文件编辑、测试运行的 agent 工作流中,Claude 同样领先。
Claude Code 的设计进一步放大了这个优势。Anthropic 的终端原生 agent 给模型提供了结构化的文件编辑、测试运行和自我修正循环。模型能力 + agent 脚手架的组合,在 SWE-bench Pro 上产生了 69.2% 的成绩。同一个模型,在不同的 agent 脚手架下,表现可以相差 20 个百分点以上。路由决策不仅要选模型,还要选匹配的 agent 框架。
IFBench(指令遵循评测)提供了另一个维度的数据:Claude Sonnet 4.6 为 41.2%,GPT-4o 为 34.3%,Gemini 3 Pro 为 70.4%。在"精确执行用户指令"这个维度上,Gemini 大幅领先。对于需要严格遵循格式的 agent 工作流(JSON 输出、特定模板、步骤约束),Gemini 可能是更好的选择,尽管它的 SWE-bench Pro 分数低于 Claude。
数学与推理:差距悬殊
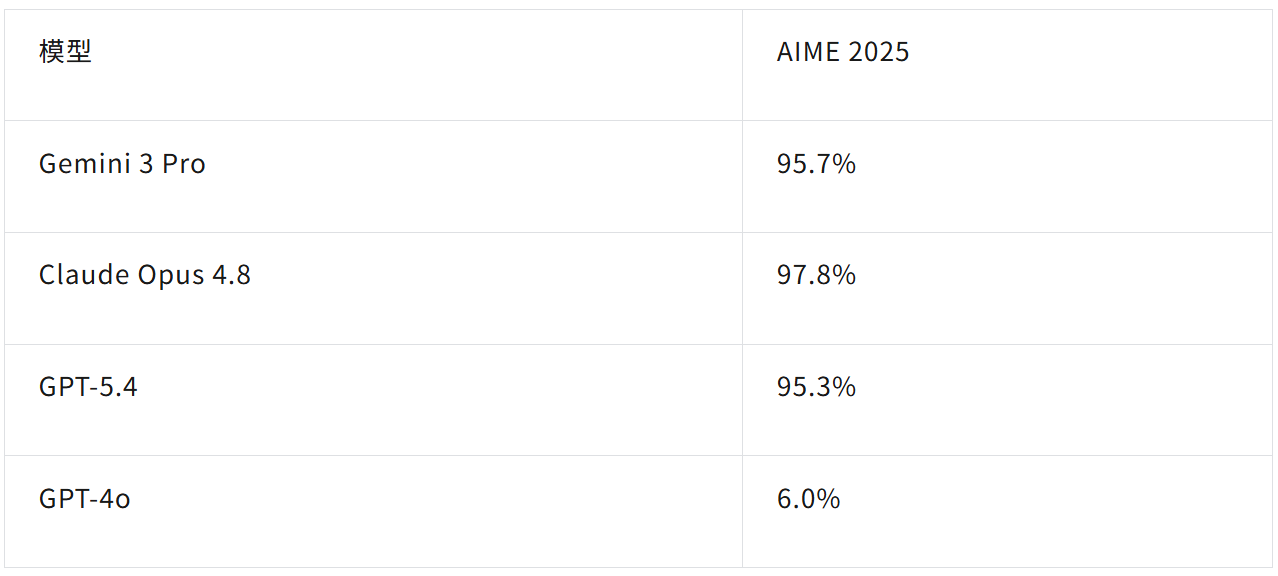
AIME 2025(美国数学邀请赛)的成绩分化极为明显:
AIME 2026 的数据进一步拉大了分化:
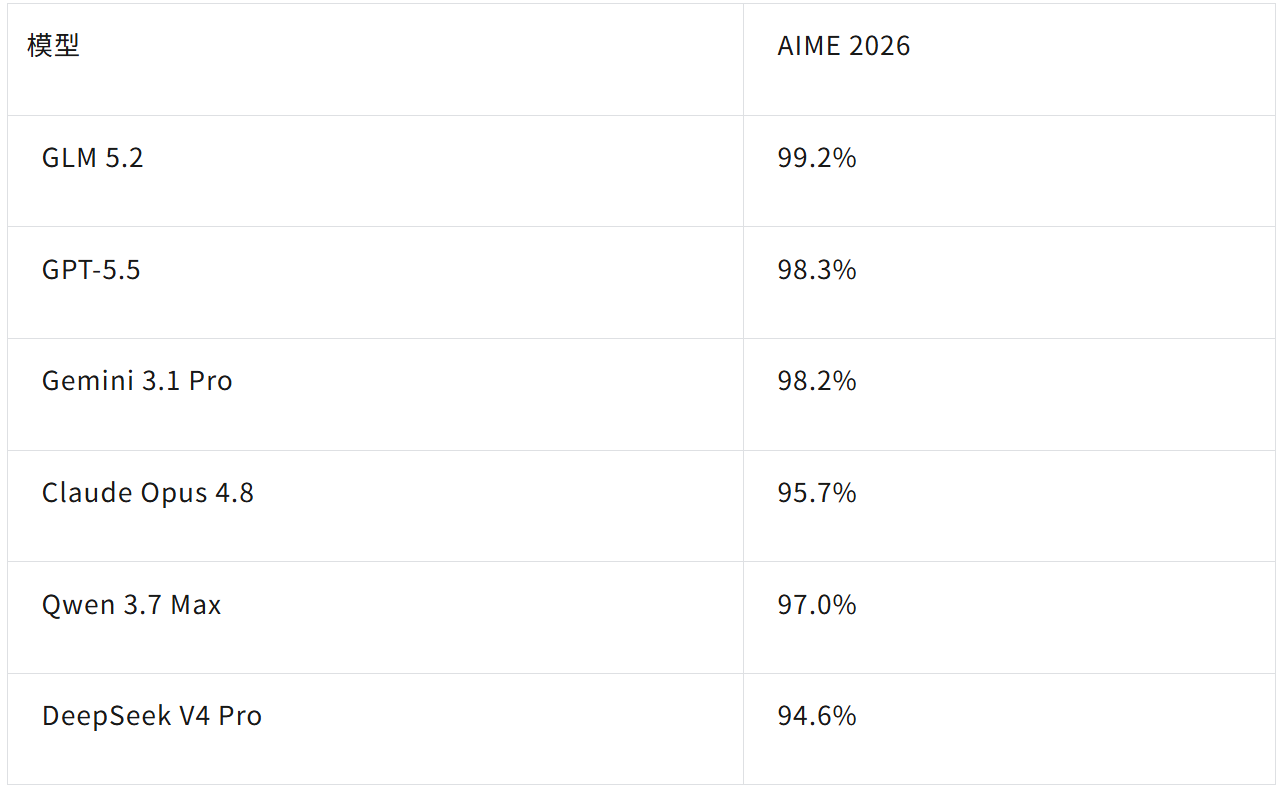
GLM 5.2 在 AIME 2026 上达到 99.2%,与 GPT-5.5(98.3%)和 Gemini 3.1 Pro(98.2%)同处第一梯队。Qwen 3.7 Max 97.0%,DeepSeek V4 Pro 94.6%,均处于推理增强模型的合格区间。同一个评测,通用 GPT-4o 在 AIME 2025 上只有 6.0%。数学推理不是"好一点"和"差一点"的区别,是能力层级之间的断层。
GPQA Diamond(PhD 级科学推理)上三家旗舰差距较小:Gemini 3.1 Pro 94.1%,GPT-5.5 94.0%,Claude Opus 4.8 93.6%。科学推理是三家都能打的高地,差距在 1 个百分点以内。
LiveCodeBench 呈现另一种分化:Gemini 3 Pro 91.7%,Claude Sonnet 4.6 未公布,GPT-4o 30.9%。某些编码子维度上,Gemini 可以大幅领先。能力分化不是"一家全面强",是"不同子任务不同赢家"。
写作、速度与上下文
LMArena 人类偏好排名(2026 年):Claude Opus 4.8 第一(约 1510 Elo),GPT-5.5 第二,Gemini 3.1 Pro 第三。Claude 在写作质量和整体回答偏好上占优。QuickSaaS 的评测描述:"Claude 在写作和散文质量上 best-in-class,GPT-4o 在 STEM 和逻辑推理上 best-in-class,Gemini 在多模态视觉理解上 best-in-class。"
速度是另一个维度。GPT-4o 的生成速度约 194 tokens/s,Claude Sonnet 约 47 tokens/s,差距 4 倍。TTFT(首 token 延迟)方面,GPT-4o 约 0.61 秒,Claude Sonnet 约 1.11 秒。对于需要快速响应的交互式场景,GPT 的速度优势是实际的用户体验差异。
上下文窗口是结构性的分化。Gemini 提供 1M 到 2M tokens,Claude 为 200K 到 1M,GPT 为 128K 到 1M。整库推理、长文档分析、跨数百个文件的关联搜索,Gemini 的上下文优势不是分数上的几个百分点,是"能做"和"不能做"的区别。一个 50 万行的代码库,Gemini 可以一次性装入上下文,Claude 和 GPT 需要分段处理或依赖 RAG 检索。分段处理会丢失跨文件的关联信息,RAG 检索有召回率的上限。
多模态能力也呈现分化。Gemini 在视觉理解上被多家评测称为"outstanding",GPT-4o 在图像生成和编辑上领先,Claude 在文档 OCR 和图表解读上表现稳定。一个需要分析 UI 截图的 agent 任务,Gemini 可能是最佳选择;一个需要生成产品 mockup 的任务,GPT-4o 更合适。模态类型应该成为 router 的输入特征之一。
DeepSeek V4 Pro 代表另一条路线。缓存未命中 $0.435/$0.87,缓存命中 $0.003625/M,SWE-bench Pro 55.4%。V4 Flash 定价 $0.14/$0.28,适合高吞吐场景。在自托管场景下 API 费用为零,只需承担 GPU 硬件成本。GLM 5.2 以 MIT 许可发布,SWE-bench Pro 62.1%,自托管同样零 API 费用。对于数据不出境、延迟要求低、吞吐量大的场景,中国开源模型提供了"能力接近 frontier、成本接近 zero"的选项。Open-weight 模型与 closed-source 模型在编码评测上的差距,在 2026 年已经缩小到 7 个百分点以内(GLM 5.2 62.1% vs Opus 4.8 69.2%)。
主观实测:没有单一赢家
danilchenko.dev 的一位工程师在 2026 年 5 月做了三周轮换实测。同一组日常编码任务,分别用 Claude Opus 4.7、GPT-5.4、Gemini 3.1 Pro 完成。
结论原文:"There's no single winner — just a routing decision."
具体观察
- Claude Opus 在跨三个以上文件的重构中表现最稳定,单次回答质量最高。SWE-bench Verified 83.5%,是三家中最高的。
- GPT 在同等 agent 循环中输出 token 数比 Claude 少约 72%(Mindstudio 测试数据)。循环成本显著更低。对于需要多轮迭代的 agent 工作流,token 效率直接影响账单。
- Gemini 在规格明确的问题上与其他两家接近,在需求模糊时容易过度解读。Well-specified 任务表现合格,ambiguous 任务容易跑偏。
- Gemini 混合定价约 $1.50/M(3:1 输入输出比),是三家中最便宜的。Claude Opus 混合定价约 $6.63/M,GPT-5.4 约 $5.50/M。
同一个人,同一类任务,三家各有胜场。路由决策的价值,正在于把任务导向当前最擅长的模型。
Pristren 在 2026 年 5 月的四模型对比中给出了更细的分工建议:GPT-4o 在指令遵循和工具使用上领先,Claude 3.5 Sonnet 在长文档分析和诚实不确定性表达上领先,Gemini 1.5 Pro 拥有最大的上下文窗口,DeepSeek V3 以 $0.27/$1.10 的价格提供了接近前沿的性能。四个模型,四个"领先"维度,再次验证没有单一赢家。
另一个值得注意的现象:benchmark 分数和实际使用体验之间的差距。Digital Applied 的分析指出,SWE-bench Verified 上的 88% 和 SWE-bench Pro 上的 69% 之间,存在 20 个百分点以上的落差。vendor 自己的 scaffold 和第三方标准化 scaffold 之间的分数差距,在 Claude 上可达 17 个百分点。这意味着 benchmark 分数应该被当作"层级指示器"而非"精确排名"。Router 的设计不应基于"谁 benchmark 分数最高",而应基于"谁在这个具体操作类型上历史成功率最高"。
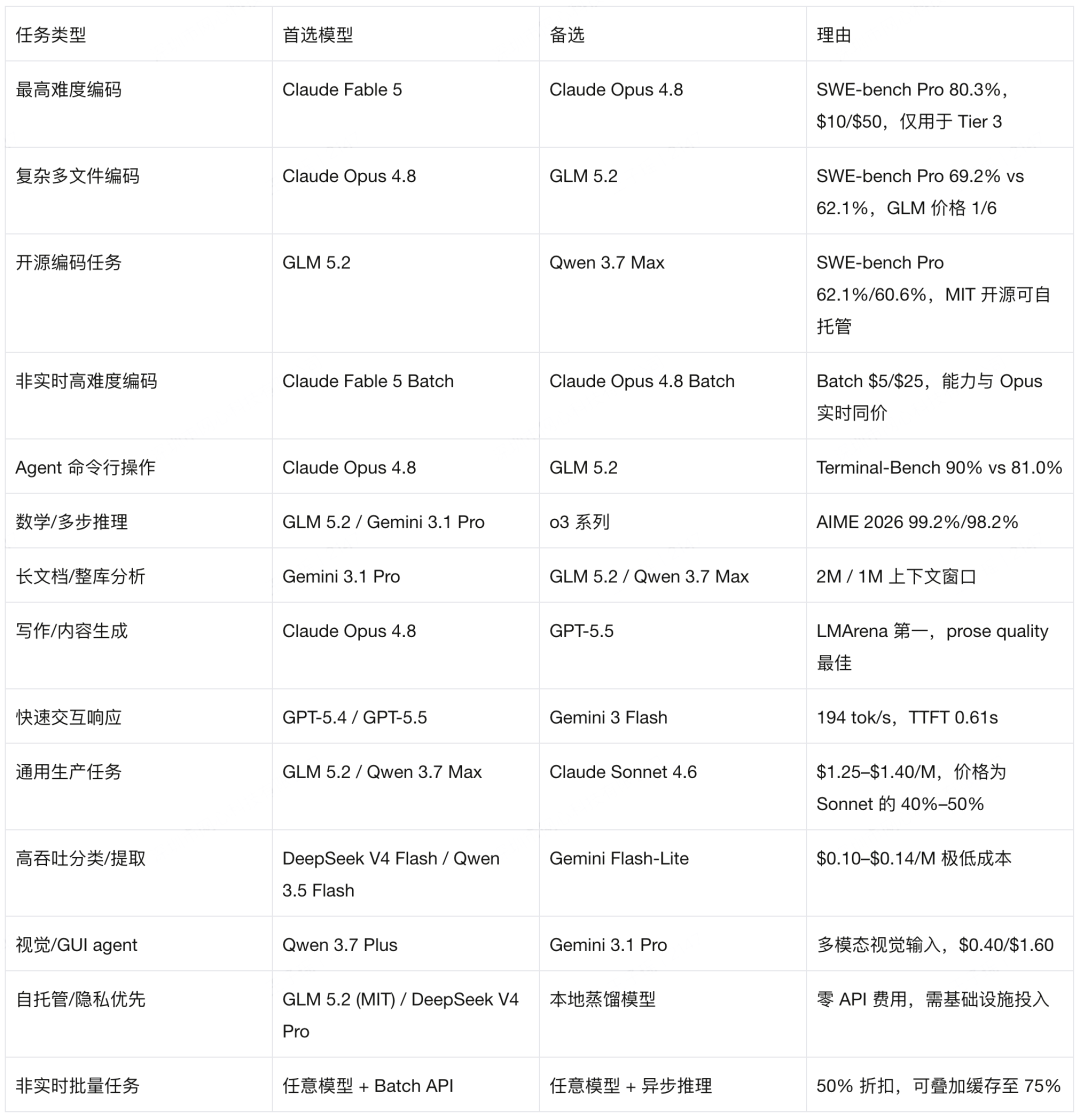
路由矩阵
把客观评测和主观实测合在一起,可以得到一张实用的路由参考:
四、Router 的设计
理解了为什么需要路由,接下来是路由怎么建。
三层架构
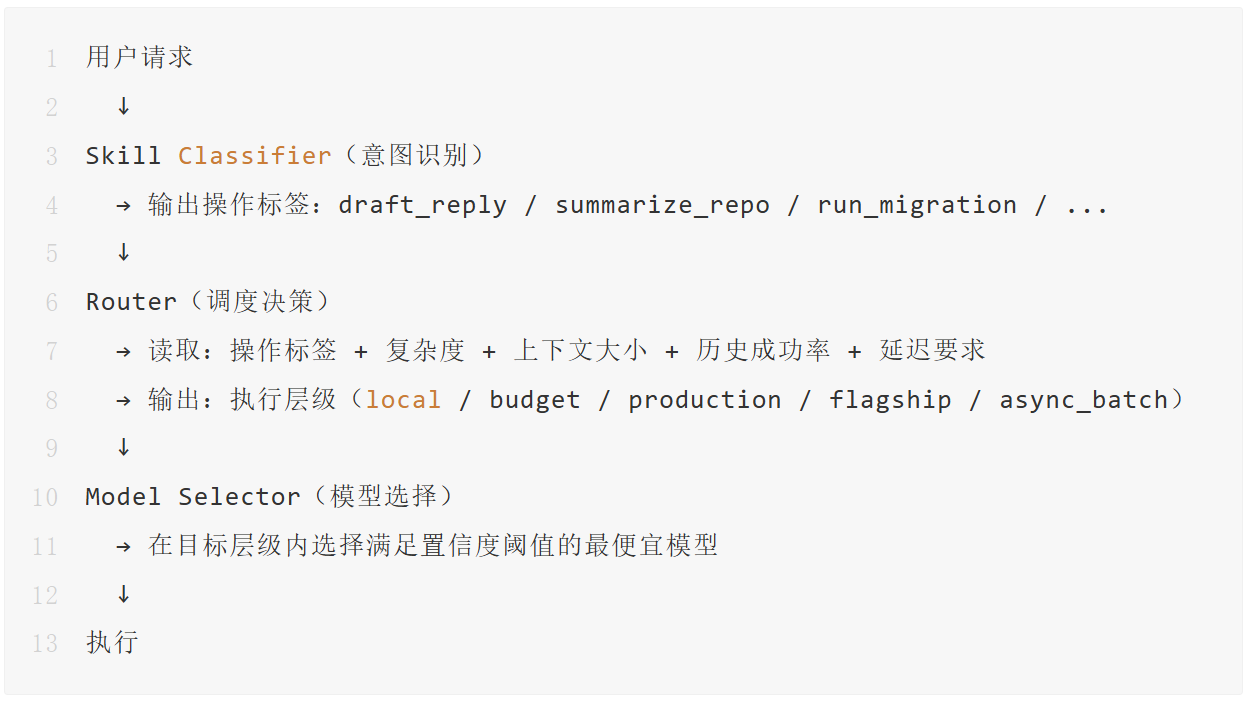
Classifier 是语言问题,可以用小模型或规则引擎完成。它的输入是用户的自然语言,输出是结构化的操作标签。一个好的 classifier 不需要理解任务的全部细节,只需要正确分类任务的类型。分类准确率 95% 以上通常就够用了,因为 router 的后续层可以处理分类错误(比如把复杂任务误分类为简单任务时,同步失败预测器会在执行阶段拦截)。
Router 是调度问题,不需要理解语言。它读的是结构化特征:这个操作的历史成功率是多少,上下文有多大,有没有实时性要求,有没有已知的失败模式。Router 的决策逻辑可以用简单的加权评分实现,也可以用夜间反馈循环自动调权重。一个典型的 router 评分函数可能是:score = w1 * complexity + w2 * context_size + w3 * (1 - historical_success_rate) + w4 * latency_requirement。分数超过阈值则升级到更高层级。
Model Selector 是经济问题。在同一层级内,比较各模型的价格和近期质量表现,选最便宜的达标选项。这里"达标"的定义由操作类型决定:分类操作的达标线是 95% 准确率,编码操作的达标线是 SWE-bench 通过率 60% 以上。不同操作有不同的质量底线,selector 在这个底线之上选最便宜的。
两个反馈机制
Tom Tunguz 描述了他们 agent runtime 中 router 上的两层反馈,运行在不同的时间尺度上。
同步失败模式预测器。 每个请求进入 router 时,预测器标注五个风险特征:缺失的仓库上下文、长依赖链、高风险迁移、安全敏感 prompt、高后果写入操作。命中风险特征的请求自动路由到更高层级,避免已知的失败模式。这一层在请求进入时即时生效,延迟为零。
五个特征的具体含义:
- 缺失仓库上下文:agent 需要修改代码,但上下文中没有引入相关的源文件。小模型在这种情况下容易幻觉出不存在的 API。
- 长依赖链:任务涉及超过 5 层的模块依赖。需要全局理解才能正确修改。
- 高风险迁移:数据库 schema 变更、API 版本升级等不可逆操作。
- 安全敏感 prompt:涉及密钥、权限、认证逻辑的修改。
- 高后果写入:修改生产配置文件、部署脚本等直接影响线上服务的文件。
夜间闭环反馈。 批量评估器在夜间用异步推理跑昨天的全部 trace,给每条路由决策打分,更新 router 的权重。评估本身跑在异步通道上,成本接近零。这一层发现预测器没有覆盖的新失败模式,持续修正路由策略。
两层反馈的关系是:同步层拦截已知问题,异步层发现未知问题。一个管当下,一个管长期。OpenAI 在 2026 年初对 SWE-bench Pro 的审查也揭示了类似的问题:约 30% 的评测任务本身存在设计缺陷。Benchmark 数据需要持续审查,router 的权重也需要持续更新。静态的路由规则会随时间退化。
技能蒸馏与本地模型
路由的终极形态,是把高端模型的能力迁移到本地模型上。Tom Tunguz 引用的数据是:经过技能蒸馏(Skill Distillation)之后,70% 到 80% 的非编码 agent 流量可以在本地模型上运行。本地推理的边际成本接近零。
蒸馏的路径是:用旗舰模型生成高质量的操作轨迹,训练本地模型模仿这些轨迹中的工具和技能调用模式。本地模型不需要理解所有语言,只需要在已知的操作集合中正确选择和执行。Tom Tunguz 引用了三篇相关文章:Full Sail on Asynchronous Inference(异步推理的成本差异)、Skill Distillation(技能蒸馏方法论)、The Minimill of AI(本地模型的工具调用能力)。
对于编码类任务,GLM 5.2 和 DeepSeek V4 Pro 在自托管场景下提供了接近 frontier 的能力。对于分类、摘要、格式化、简单问答,DeepSeek V4 Flash 和 Qwen 3.5 Flash 在 $0.10–$0.14/M 的价位已经够用。
设计原则
把以上讨论收敛为四条可执行的原则:
1. 先设计路由,后选模型。 明确系统中有哪些操作类型,每种操作的延迟要求和质量底线,再为每个层级选择模型。模型列表每季度都在变,路由结构应该稳定。今天选 Sonnet 做 production 层,明天可以换成 GPT-5.4,router 的结构不需要改。
2. 默认走便宜层。 除非有明确理由升级,所有请求从 budget 或 production 层开始。升级触发条件应该是结构化的:复杂度超阈值、历史失败率超标、用户显式要求、同步预测器命中风险特征。升级路径应该是逐级向上,不是一步跳到旗舰。
3. 异步是默认选项之一。 任何能容忍分钟级以上延迟的任务,应该走 batch 或 async 通道。在路由层显式标注延迟要求(realtime / near_realtime / async / batch),而不是事后发现"这个其实不急"。延迟要求应该是 classifier 输出标签的一部分。
4. 持续度量,持续调权重。 记录每条路由决策的输入特征、选择的层级、实际结果质量。用这些数据驱动 router 权重的自动调整。路由策略不是一次性的配置,是持续优化的调度系统。Coinbase 的经验表明,routing + caching + better defaults 三管齐下,可以在 token 用量增长的同时保持成本 flat。
升级路径与降级策略
Router 不只需要决定"用什么",还需要定义"什么时候升级"和"什么时候降级"。
升级路径(Escalation): 请求在 budget 层执行后,如果结果质量不达标(分类置信度低于阈值、代码编译失败、用户反馈 negative),自动升级到 production 层重试。Production 层仍失败,升级到 flagship 层。每升一级,成本增加 3 到 10 倍,质量预期也相应提升。大多数请求在 budget 或 production 层就能成功,只有极少数需要走到 flagship。
降级策略(Downgrade): 当 flagship 层的某个操作类型的历史成功率持续高于 99%,且连续 30 天无失败案例,router 可以自动将该操作类型的默认层级下调一级。这意味着系统在学习:这个操作类型已经不需要那么强的模型了。降级是成本优化的长期机制,与升级路径对称。
A/B 测试: 因为 classifier 和 router 解耦,可以对同一操作类型同时路由到两个不同模型,比较质量差异。比如把 10% 的摘要请求发给 Flash-Lite,90% 发给 Sonnet,比较两者的用户满意度。如果差异不显著,逐步扩大 Flash-Lite 的比例。这种数据驱动的方式,比凭直觉选模型可靠得多。
常见反模式
在路由设计中,有几个反复出现的错误模式值得警惕:
反模式一:单一模型走天下。 所有请求发给同一个模型,通常是团队最先选定的那个 flagship。这是最常见的起点,也是成本最高的状态。除非日请求量极低(每天几百次以下),否则几乎一定存在路由优化空间。
反模式二:在 prompt 里做路由。 "如果这个问题很简单,请简短回答;如果很复杂,请详细分析。" 模型不会可靠地执行这种自我路由指令。它倾向于过度回答,因为训练数据中"详细"通常获得更高奖励。路由必须在 prompt 之外完成。
反模式三:忽略延迟维度。 只按任务难度路由,不考虑时间要求。一个可以等两小时的报告摘要和一个需要三秒内回复的客服对话,应该走不同的执行通道,即使它们的任务难度相同。
反模式四:静态路由规则。 路由表写一次就不再更新。模型在快速迭代(每季度都有新版本),任务分布也在变化(产品功能增加后,新的操作类型出现)。没有反馈循环的路由系统,会在 3 到 6 个月内退化。
反模式五:跳过 classifier 直接路由。 有些团队试图用正则表达式或关键词匹配代替 classifier,直接决定路由层级。对于固定格式的请求(如 API 调用、内部工具触发),规则路由可行。对于自然语言输入的用户请求,跳过 classifier 会导致大量误分类。一个"帮我看看这个 bug"的请求,可能是简单的日志查看(Tier 0),也可能是复杂的多文件调试(Tier 2)。没有意图识别,router 无法做出正确判断。
结语
回到开头的问题。团队在做 AI 系统时,最常见的起点是"我们用哪个模型"。这个问题本身没有错,它只是被放在了错误的位置。
模型是执行层的资源,router 是调度层的架构。架构决定了资源的使用效率。一个设计良好的 router,可以让 70% 到 80% 的流量跑在近乎免费的本地或异步模型上,把旗舰模型的算力集中在真正需要它的 20% 到 30% 的请求上。同时,路由保证每个请求到达最擅长该类任务的模型,而不是统一到达某一个"最强"模型。
三个事实支撑这个判断:
成本: 2026 年 7 月的 API 定价表中,最便宜和最贵模型之间的价差超过 400 倍。一个设计合理的 router 可以将整体 AI 开支降低 60% 到 90%。Coinbase 和 Tom Tunguz 的实践数据都指向这个区间。路由不是削减功能,是把算力用在真正需要的地方。
质量: SWE-bench Pro 上 Claude 69.2% vs GLM 5.2 62.1% vs GPT-5.5 58.6% vs DeepSeek V4 Pro 55.4%,AIME 2026 上 GLM 5.2 99.2% vs GPT-4o 6.0%,IFBench 上 Gemini 70.4% vs GPT-4o 34.3%。不同模型在不同任务上的差距不是几个百分点,是 10 到 90 个百分点的量级。统一使用一个模型,意味着在大多数任务上要么浪费算力,要么牺牲质量。Router 是同时优化成本和质量的双杠杆。
调度: 当前模型无法根据问题难度自动降低计算复杂度。这个问题短期内不会消失,因为模型的训练目标是"尽可能好地回答",不是"用尽可能少的算力回答"。Router 是弥补这个结构性缺陷的外部机制。在模型自身具备这种能力之前,路由是成本优化的唯一可靠路径。
Tom Tunguz 的最后一句说得很直接:"Design your system around routing, not around models. Pick your models last." 设计系统时围绕路由,而非围绕模型。模型最后选。先画路由架构图,再填模型名字。
人类社会用了几百年验证分工的效率。AI 系统不需要等那么久。价格表和评测数据已经给出了足够清晰的分工依据。Classifier 识别意图,Router 做调度,Model Selector 在层级内比价。三层解耦,各自独立迭代。剩下的工作,是把这套调度逻辑写出来,然后让它在夜间反馈循环中持续变聪明。
参考资料
- Tom Tunguz, Most AI Work Can Wait
- Brian Armstrong (Coinbase CEO), X 平台公开发言(2026 年初,routing + caching + better defaults 使 AI 开支减半)
- vals.ai, SWE-bench Verified
- Digital Applied, SWE-bench in 2026: Benchmarks vs Scaffolding Reality
- LMArena, Chatbot Arena Leaderboard
- QuickSaaS, Claude 4 vs GPT-4o vs Gemini 2.5 (2026)
- Pristren, GPT-4o vs Claude 3.5 vs Gemini Pro vs DeepSeek V3 (2026)
- tech-insider.org, Claude vs ChatGPT vs Gemini 2026
- Tom Tunguz, Skill Distillation, Teaching Local Models to Call Tools Like Claude