网心技术 | RSI:当 AI 学会改进自己
前言:分层思维到智能系统的自进化
人类之所以能应对复杂世界,很大程度上依赖于在时间中不断基于经验更新自我——我们通过外部反馈,借助证实与证伪的工具,持续修正自己的认知模型。然而,当前的人工智能体还远未具备这种能力;它们的“学习”往往局限于训练阶段,部署后难以动态演进,更无法像人一样在日常交互中自发地校准信念、重组知识结构。正因如此,如何让AI系统实现递归自我改进,成为了一个根本性的挑战。
Lilian Weng 在 2026 年 7 月发表了一篇关于 Harness 工程与自我改进的长文。几乎同一时期,一篇关于自进化 Agent 系统的综述和一篇关于时空组合性编程范式的论文也相继出现。三篇文章从不同角度指向了同一个核心问题:AI 系统如何实现递归自我改进。
本文结合对模型架构和硬件协同的分析,尝试给出一个系统性的全景图。
数学家如何看待世界?从集合论到代数结构,从拓扑空间到范畴论,现代数学的基本方法论是:先确立最基本的元素和公理,在此之上层层构建,形成一套形式化的体系。这套体系不是为了描述某一个具体的现象,而是为了建立一种看待世界的系统性框架。
工程师,尤其是计算机领域的工程师,有着异曲同工的方法论:分层与模块化。面对一个复杂问题,我们的第一反应不是直接去解决它,而是把它拆成不同的层次,如物理层、链路层、网络层、传输层、应用层。在同一层内,我们又用不同的模块组合来构成这一层的能力。
这种方法论有两个根本性的好处。第一,它帮助人类理解复杂系统。第二,更重要的,它让我们可以在效率和灵活性之间做出精细的权衡。
如果所有问题揉在一起考虑、一体化开发,效率可能是高的,灵活性就缺失了,任何改动都可能牵一发而动全身。如果所有东西都拆成独立的服务,灵活性提高了,通信开销和协调成本也随之上升。考虑到物理层的硬约束(单个 CPU 或单台服务器不可能无穷大),有时候,我们不得不通过灵活性来换取整体效率。
今天,模型能力不断提升,SWE-agent 在软件工程任务上展现出极高的水平。我们需要用同样的分层思维来理解一个根本性的问题:一个完整的 AI Agent 到底由什么构成?它的整体能力提升,到底来自哪里?而这个提升过程,能否变成自动化的、递归的、自我驱动的?
这就是本文要讨论的核心:递归自我改进(Recursive Self-Improvement, RSI)。
一、解构 Agent:模型与 Harness
我们说一个 coding agent 很强的时候,我们在说什么?表面上看,我们在评价一个模型。实际上,一个完整的 Agent 远不止是一个模型。
用 Lilian Weng 的话来说,Harness 是模型与真实世界之间的那一层,它的重要性不亚于模型本身的原始智能。更形式化地,我们可以把一个 Agent 在时间步 t 的配置定义为:
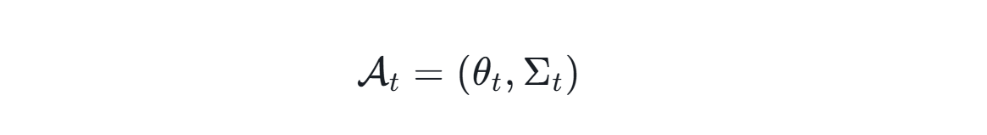
其中 θₜ 是模型的参数,提供了核心智能;Σₜ 是围绕模型的运行时系统(也就是 Harness),它进一步分解为:
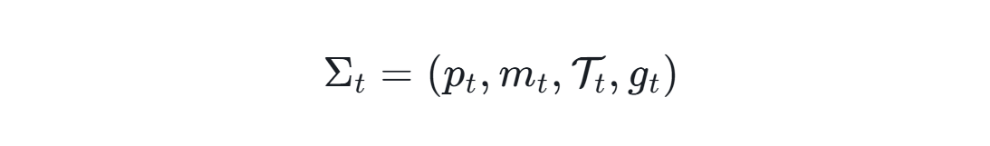
- pₜ:系统指令与提示词(Prompt),负责组织上下文、引导模型的行为边界;
- mₜ:记忆系统,涵盖短期工作记忆、长期经验积累、知识库的检索与更新策略;
- Tₜ:工具集,包括文件操作、代码执行、网络搜索、子 Agent 调度等;
- gₜ:控制逻辑,包括工作流编排、权限管理、安全策略、状态管理
以当前最成熟的 coding agent 产品之一 Claude Code 为例
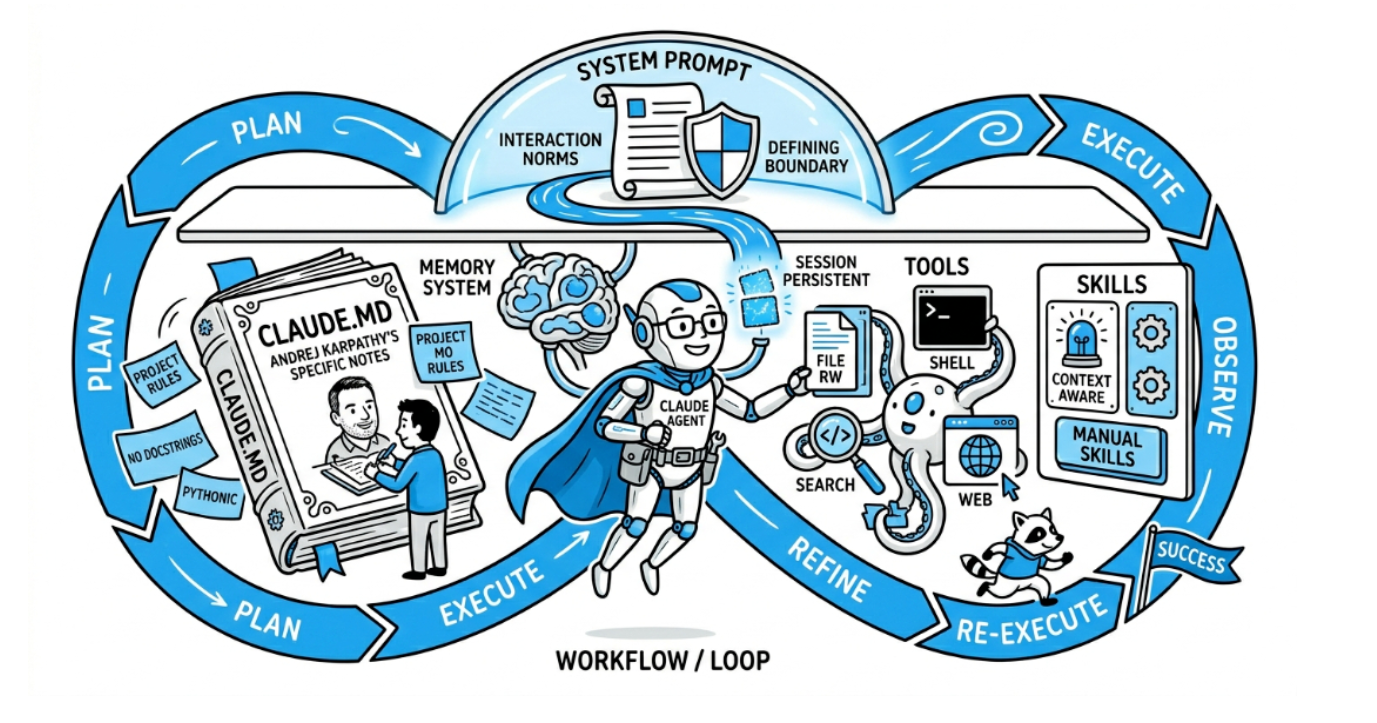
这些层次清晰可见:
- System Prompt:定义整个 Agent 的行为边界、交互规范和安全约束;
- 记忆系统:Claude Code 的 memory 机制,在会话之间持久化关键信息;
- claude.md:用户自定义的规则和偏好(如 Andrej Karpathy 广为流传的那份 claude.md),定义了个性化的编程风格、项目约定和工作习惯;
- Tools:文件读写、Shell 执行、代码搜索、Web 搜索等工具定义;
- Skills:在特定场景下自动触发的技能模块,有些是自动检测调用,有些是手动触发;
- Workflow / Loop:Agent 的执行循环,即规划、执行、观察、改进、再执行
所以,整体能力 = 模型提供的智能 + Harness 提供的运行时能力。在某个具体时间点,一个 Agent 能解决多难的问题,取决于模型和 Harness 的共同水平。
二、RSI:一个古老愿景的现代实现
递归自我改进的概念可以追溯到 1965 年。I. J. Good 提出了"超智能机器"的构想:一台能在所有智力活动中超越人类的机器,能够设计更好的机器来改进自身。2008 年,Yudkowsky 正式使用了"递归自我改进"这个术语,描述了一个具体的反馈环:一个 AI 使用其当前的智能来改进产生其智能的机制本身。
在现代 AI 的语境下,这个反馈环可以有两种实现方式:
第一种,模型直接改写自己的权重。这在短期内还不现实。
第二种,更实际的路径:模型改进训练流程和部署系统,从而产出更好的下一代模型。同时,模型改进自己的 Harness,使得同样的模型在更好的 Harness 下展现出更强的能力。
用前面的形式化语言来说,自我改进就是一个自诱导的更新算子。更新算子定义为:
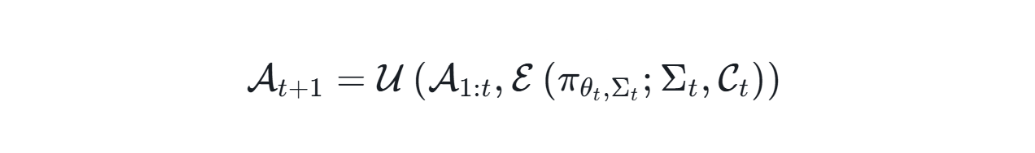
Agent 执行任务产生经验,然后用这些经验来更新自身的配置,无论是权重 $$ het$$ 还是 Harness $$Sigm$$。这不是一次性的改进,而是一个持续运转的循环。
Lilian Weng 对近期 RSI 实现路径的预测是:Harness 工程将向元方法论的方向演进。核心不是改进答案本身,而是改进获得更好答案的机制。Harness 系统本身成为优化目标,减少启发式规则,增加通用机制。反过来,成熟的 Harness 使得模型自我改进的循环成为可能,更强的模型又能防止 Harness 过度工程化,保持系统的可持续性。
三、模型自身的进化
自进化智能系统的第一个维度是模型本身的进化。
3.1 训练基础设施
更快的训练需要三个要素的同步提升:更好的硬件、更高的计算效率、更好的数据。这三者缺一不可。
3.2 模型结构的创新
在模型结构层面,当前最具代表性的两条路线来自 DeepSeek 和 Kimi(月之暗面)。
DeepSeek 的演进路线:在 V2/V3 中,DeepSeek 引入了 MLA(Multi-head Latent Attention),通过低秩联合投影压缩 KV Cache 的头维度,大幅降低推理时的显存占用。到了今年发布的 V4,架构发生了根本性的变化。MLA 被 CSA(Compressed Sparse Attention)和 HCA(Heavily Compressed Attention)的混合注意力架构所替代。CSA 沿序列维度将每 4 个 token 的 KV Cache 压缩为 1 个条目,然后用稀疏注意力选取 top-k;HCA 则更激进,每 128 个 token 压缩为 1 个条目,做密集注意力充当全局摘要。同时,V4 用 mHC(Manifold-Constrained Hyper-Connections)替代了传统残差连接,使百万 token 上下文原生可行。
Kimi K3 的架构选择:作为全球首个开源的 3T 级模型,K3 走了一条不同的路线。它以 KDA(Kimi Delta Attention,一种高效的线性注意力)为主体,按 3:1 的比例交替穿插 Gated MLA 层,合计 69 层 KDA 加 24 层 Gated MLA。KDA 提供高效的长序列混合,Gated MLA 保留全局 token 间的精确交互。同时,K3 引入了 Attention Residuals(AttnRes),让每一层可以选择性地 attend 到所有前序层的输出,实现跨层信息的选择性回溯。在 MOE 层面,K3 将路由专家扩展到 896 个,每个 token 激活 16 个。
这两种架构选择的背后,都有深刻的硬件协同考量。
3.3 模型与硬件的协同设计
模型结构不是在真空中设计的。它必须和推理硬件、训练集群做深度协同。
Attention 计算的硬件适配。不管是哪个变种的注意力机制,其核心都是矩阵乘法加上一个特殊函数单元(SFU),比如 Softmax。即便 Kimi 的 KDA 用线性替代减少了 Softmax 的使用,没有被替代的那部分仍然需要 Softmax 计算。这就需要考虑在芯片的计算单元上如何高效部署它。SRAM 的大小、计算核的流水线深度、数据搬运的延迟,都会影响最终的吞吐。
KV Cache 与显存管理。KV Cache 放在 HBM 显存还是通过某种分层缓存策略管理?整个推理系统的显存如何规划?这些决策直接影响了模型能支持多长的上下文和多大的并发。DeepSeek V4 的 CSA/HCA 混合架构将 KV Cache 压缩到标准 Transformer 的约 2%,正是为了在硬件约束下实现百万 token 推理。
MOE 层与专用硬件。以 Groq 的 LPU 为例,它采用了纯 SRAM 架构,每颗芯片 230MB 的片上 SRAM,没有任何外部 DRAM 或 HBM,内部带宽达 80 TB/s。这种设计的核心思路是:MOE 或 FFN 层本质上是无状态的(Stateless)。给定输入,读取权重,计算输出,不需要像 Attention 层那样累积 KV Cache。如果片上 SRAM 足够大,权重可以常驻,每次推理都不需要从外部存储重新加载。单颗芯片的 SRAM 容量有限(230MB),因此大模型必须分布到多颗 LPU 组成的集群上,以流水线方式协同推理。
Scale-up 域的规模选择。这里有一个深层的物理约束问题。芯片的几何尺寸增长在纳米工艺下已经接近极限,单芯片不可能无穷大。那么我们组建的 scale-up 域(紧密耦合的计算集群)到底该多大?以 GPU 为例,是 64 卡的机箱还是 128 卡?如果规模太大,容错(fault tolerance)怎么做?如果计算核心很大,而需要等待的数据搬运量也大,那么网络或芯片间的任何传输延迟都会导致计算单元空转(idle)。规模太大了,小数据包的通信协调开销与计算模块的算力粒度不匹配,同样会导致效率下降。
这些都不是孤立的问题。模型架构会考虑硬件的特性,硬件也会为特定的模型做定制调整,最终达到一个协同优化的最佳点。
3.4 模型优化的自动化
Andrej Karpathy 的 autoresearch 项目提供了一个简洁的范例:定义一个目标导向的循环(规划、执行、观察/测试、改进、再执行),直到目标达成。AI Scientist 系统将这个循环扩展为完整的科研流程:提出研究想法、编写代码、运行实验、分析结果、撰写论文、同行评审。
在这个方向上,可以考虑的变量远比表面看到的要多。除了模型结构和训练数据,还包括推理部署效果、强化学习阶段的奖励设计等。比如,我们是训练一个像 PPO 那样具有长程轨迹跟踪能力的算法,还是像 GRPO 那样最终只关心结果的算法?奖励信号是看过程中的分布,还是只看最终结果?这些算法选择本身,是否也可以被自动优化?
答案是肯定的。这正是 RSI 在模型层面的终极形态:不只是改进模型,而是改进产生模型的方法。
四、Harness 的自动化提升
如果说模型的进化是 RSI 的"内核",Harness 的自动化提升就是 RSI 在工程落地中更具实操性的那一面。正如 Lilian Weng 文章的标题所揭示的(Harness Engineering for Self-Improvement),Harness 的每一个环节都可以被自动化地优化。
4.1 优化对象的进阶
Harness 优化的对象经历了一条清晰的进阶路径:
指令提示词 → 结构化上下文 → 工作流 → Harness 代码 → 优化器代码
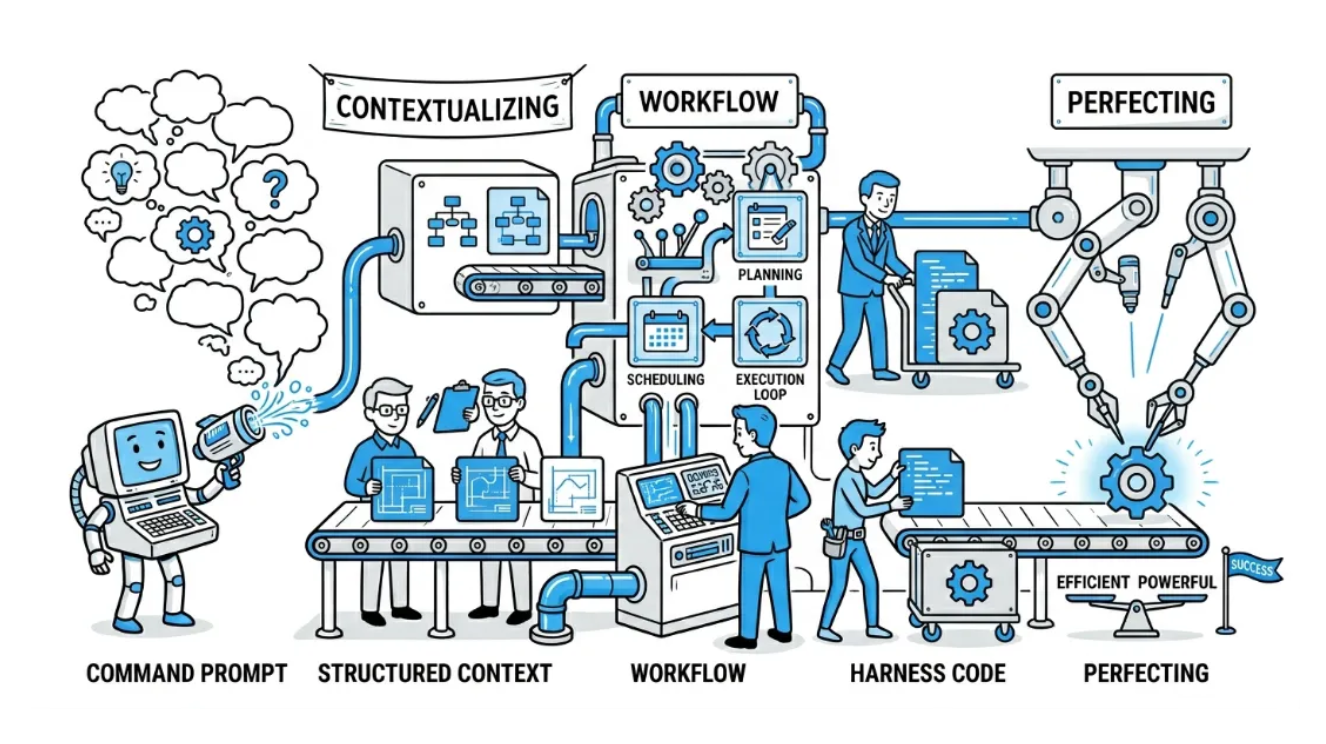
随着模型变得更强大,我们可以将更复杂的目标和更通用的方法交给自动化优化。早期是调 prompt,现在是调整整个 Harness 的代码逻辑,未来甚至是调整优化 Harness 的优化器本身。
4.2 上下文工程
随着 Agent 任务复杂度的增加,简单地将所有工具响应和模型输出拼接到上下文中,会迅速失控。上下文工程的核心问题是:如何为模型构建结构化、精炼的上下文,同时管理好持久化状态?
ACE(Agentic Context Engineering) 将上下文视为一个不断演化的策略手册(playbook),而非不断膨胀的 prompt。它包含三个组件:生成器(Generator)产生任务轨迹,反思器(Reflector)从成功和失败的轨迹中提炼洞察,整理器(Curator)用增量式的条目更新结构化上下文。关键的设计选择是:整理器不重写完整的 prompt,而是输出结构化的 (identifier, description) 条目,用确定性逻辑合并到上下文日志中。
MCE(Meta Context Engineering) 更进一步,将"如何管理上下文"(机制)与"上下文中有什么"(内容)分离开来。它定义了一个双层优化:内层优化给定技能下的最佳上下文,外层优化技能本身。技能数据库记录历史技能、上下文函数和评估指标,一个元级 Agent 在历史技能上做交叉变异来创造新技能。
Meta-Harness 则走得更深:被优化的对象是决定"哪些信息应该被存储、检索和呈现给模型"的代码本身。它是一个用来优化 Harness 的 Harness,名字中的"Meta-"正是这个意思。提议新 Harness 的角色本身就是一个 coding agent,最终输出是 Pareto 前沿上的一组 Harness 候选方案。
4.3 工作流的自动搜索
工作流的设计空间是巨大的。既然如此,我们自然可以把工作流设计视为一个搜索问题。
ADAS(Automated Design of Agentic Systems) 将 Agent 设计本身形式化为优化问题。一个元 Agent 以代码的形式编写新的 Agent 工作流,通过自我精炼检查其新颖性,评估后将成功的候选加回归档,迭代至收敛。
AFlow 将工作流表示为图结构,节点是 LLM 调用,边是代码中的逻辑操作。优化过程使用蒙特卡洛树搜索(MCTS):初始化模板工作流,选择节点,让 LLM 基于评估表现生成修改版本,执行评估,将改进的版本加回搜索树,重复直至收敛。实验表明,AFlow 在问答、代码和数学任务上均优于手工设计的工作流和 ADAS。
4.4 自进化 Harness
上下文工程和工作流设计各自只是 Harness 的一部分。我们需要的是对 Harness 的全设计空间进行联合搜索:上下文管理逻辑、工作流、权限控制,以及其他所有组件一起优化。
STOP(Self-Taught Optimizer) 是递归改进的一个早期经典。它的目标不是直接改进解决方案 s,而是改进"改进器" I 本身:
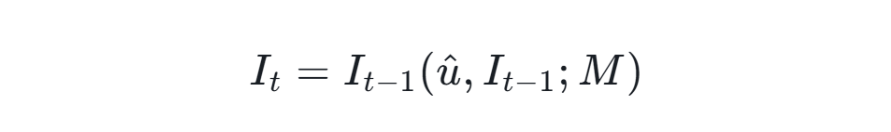
在实验中,改进后的改进器自主发现了遗传算法、分解改进、多臂 prompt 赌博机、模拟退火、变温采样、树搜索等多种策略。一个关键发现是:STOP 在 GPT-4 上持续改进,在更弱的模型上却退化了。递归结构本身不够,基础模型必须足够强大,才能改进机制本身。
Self-Harness 更贴近实际应用。它通过一个三阶段循环来实现 Harness 的自我改进:
- 弱点挖掘(Weakness Mining):用当前 Harness 执行任务,收集执行轨迹,将失败聚类为有验证器支撑的失败模式。关键在于区分表面相同、根因不同的失败。比如"超时"可能是工具调用逻辑的问题,也可能是上下文过长导致的。
- Harness 提案(Harness Proposal):基于挖掘出的失败模式,在有约束的提案空间内提出 Harness 编辑方案。优先处理反复出现的、可寻址的错误模式,编辑候选应当多样且互不重叠。
- 提案验证(Proposal Validation):在 held-in 数据集(验证弱点是否解决)和 held-out 数据集(检查是否引入新问题)上评估候选编辑,只接受在两个数据集上都不退化的修改。
AHE(Agentic Harness Engineering) 进一步强调了可观测性(Observability)的核心地位:
- 组件可观测性:每个可编辑的 Harness 组件(系统 prompt、工具描述、工具实现、中间件、技能、子 Agent 配置、长期记忆,共 7 类)都在文件系统中有明确的表示
- 经验可观测性:将大量原始轨迹分析、聚合为分层的证据和失败模式,而非全部塞入 prompt
- 决策可观测性:每次编辑都配有对下一轮结果的预测,使其成为可证伪的声明
在进化搜索方向,AlphaEvolve 提供了一个通用的框架:维护一个候选程序池,用 LLM 生成 diff 来改进候选,评估后保留优秀的个体。代码中需要改进的区域用 EVOLVE-BLOCK-START 和 EVOLVE-BLOCK-END 显式标记,元 prompt 也随解决方案共同演化。Darwin Gödel Machine(DGM) 则专门针对 Harness 代码的进化。Agent 被允许修改自己的 Harness 代码仓库,用进化搜索在固定模型下发现更好的 Harness。实验中,DGM 在 SWE-bench Verified 上将通过率从 20% 提升到 50%。
4.5 联合优化:Harness + 模型权重
如果说前面的工作是在固定模型下优化 Harness,那么真正的全面自我改进应该同时更新 Harness 和模型权重。
SIA(Self Improving AI) 是这个方向的一个早期尝试,设计了三个组件:Meta-Agent 提议初始 Harness,Task-Specific Agent 执行任务,Feedback-Agent 根据近期轨迹决定是更新 Harness 还是更新模型权重。这个方向的挑战在于训练稳定性和 Goodhart 效应(优化代理指标而非真正目标),这些问题仍然开放,值得持续关注。
五、自进化 Harness 的工程
前面我们看到,Harness 的每一个组件(工作流、技能、上下文管理、状态管理)都可以在运行过程中获得更新。这引出了一个关键的工程问题:如何在不中断服务的情况下,安全地更新 Harness 的组件?
来自北大和 DeepSeek 的一篇论文提出了 Cordis 框架,用一种形式化的"时空组合性"范式来解决这个问题。
现有的插件化系统面临两个根本性的缺陷。
第一,缺乏时间组合性。加载一个新插件后,如果需要卸载,往往要重启整个系统。以 VSCode 为例,在安装量前 100 的扩展中,87 个包含可执行代码,卸载它们都需要重启扩展宿主进程。对于一个持续自进化的 Agent Harness 来说,每次自我修改都触发完整重启意味着丢弃所有进程内累积的状态,中断正在进行的任务。一次错误的自我修改甚至可能禁用恢复所需的进程本身。
第二,缺乏空间组合性。当我加载了一个新的组件,依赖这个组件的其他组件如何感知?如何保证自身的有效性?如果依赖的组件消失了或者接口变了,没有结构化的方式来管理这种级联影响。
两者统一到一个 Context 类型中,构成了一个完整的编程范式。在此基础上,论文给出了动态组合的一个演算(calculus),并证明了从单个组件到整个交错组件系统的时空组合性保持定理。
Cordis 的实现提供了:effect 追踪和 coeffect 解析的核心库;声明式的组件加载器,支持配置协调和热模块替换(Hot Module Replacement)。
这解决了自进化 Harness 在工程上的关键问题。有了时空组合性的保证,Harness 的任何组件(工作流逻辑、技能模块、上下文管理策略、状态管理器)都可以在运行中被安全地替换、更新或回滚,而不影响系统的其他部分。依赖于被更新组件的其他组件会通过 coeffect 机制自动感知变化并做出适应。
这正是 self-improving harness 在工程实践中所需要的底层能力。如果把前面第四部分讨论的各种 Harness 优化方法(Self-Harness、AHE、DGM 等)视为"搜索和发现更好的 Harness 配置",那么 Cordis 提供的时空组合性就是"安全地将发现部署到运行中的系统"的工程基石。
六、全栈视角:RSI 作为系统工程
如果我们把视野拉得更远,RSI 应该把提升智能(或者说解决问题)所需要的一切都纳入进来。
模型能力提升需要什么?更好的结构、更好的数据、更好的训练算法。更快的训练需要什么?更好的硬件、更高效的并行策略、更优的通信拓扑。更好的部署需要什么?模型与硬件的协同设计、推理引擎的优化、服务架构的调度。
从芯片设计到网络拓扑,从训练框架到推理引擎,从 Harness 逻辑到评估基准,这些都可以成为 Agent 推理和优化的对象。RSI 不是单一维度的改进,而是一个系统性的工程。
当然,不同层面的变化速度差异巨大。硬件的迭代以年计,模型架构的革新以月计,而 Harness 的优化可以以天甚至小时计。这意味着在实践中,我们应该把主要精力集中在变化最快、杠杆最大的层面:模型的自动化改进和 Harness 的自动化提升。
对于企业来说,这意味着一个具体的战略方向:构建一个能够自进化的 Harness 系统。将自己的领域专家知识(domain expertise),无论是金融风控的规则、医疗诊断的流程还是工业制造的 know-how,转化为指导 Harness 进化的评估标准和优化信号。
具体来说,这可以参照几种已经被验证的方法:
- ACE / MCE 式的上下文进化:将领域知识编码为结构化的上下文条目,通过执行反馈不断精炼
- Self-Harness / AHE 式的弱点驱动改进:用领域特定的测试用例作为评估基准,自动发现和修复 Harness 的薄弱环节
- DGM / AlphaEvolve 式的进化搜索:在 Harness 代码空间中搜索更好的解决方案,用领域指标作为适应度函数
- 模型能力本身的提升是持续的,无论是从 scaling law 的角度还是从架构创新的速度来看,基础模型会持续变强。在此基础上,Harness 也会利用这些方法,在各行各业获得快速的能力提升。
七、挑战与展望
RSI 的研究进展迅速,若干根本性的挑战仍需面对。
7.1 弱且模糊的评估器
当前的自我改进循环在评估指标可量化、客观的任务上效果最好,这与强化学习的适用条件一致。许多有价值的能力仍然难以精确衡量,包括研究品味、创新性、长期科学价值,乃至代码的可维护性和架构的优雅程度。
如果奖励来自单元测试,Agent 可能过拟合到测试用例上;如果来自评判模型,可能学会针对特定评判者的 reward hacking 技巧;如果来自 benchmark 分数,可能利用 benchmark 的数据偏差。评估器和权限控制应该位于进化循环之外,配合留存测试、轨迹审计和关键决策点的人工审查。
7.2 上下文与记忆的生命周期
随着 Agent 变得更自主、更独立,记忆会持续增长。一个有用的 Harness 需要管理上下文和记忆,在长上下文生成的局限和长时间任务成功之间找到平衡。人类能够终身维持记忆,这暗示着上下文工程最终应该成为智能的核心组成部分,而不仅仅停留在软件系统层。
7.3 多样性坍缩
进化和强化学习循环倾向于利用已知的高回报模式。我们需要机制来防止候选群体坍缩为同一方案的变体。这在开放式研究中尤为关键,因为最佳路径在当前评估器下可能初始看起来更差。
7.4 负面结果与失败学习
研究者倾向于发表成功的结果,因此文献对成功有系统性的偏向。在大量人类创造的数据上训练的 LLM 可能不善于决定何时放弃一个假设、报告负面结果或承认失败。一个研究 Harness 应该让失败的尝试易于保存。从失败中学习是缩减搜索空间的最佳方式。
7.5 长期成功
以 coding agent 为例:它们已经显著提高了软件工程的日常生产力,许多优化目标仍然过于短期,即完成眼前的任务,不一定保护了代码库的长期健康。标准的沙箱式训练很少能捕捉到可维护性、所有权边界、迁移成本、向后兼容性或未来的调试负担。
7.6 人类的角色
人类应该向上移动到更高的抽象层次,而不是被从循环中移除。
上述挑战中的许多都需要人类的反馈和指引。毕竟,我们构建这项技术是为了人类更好的未来,而非反过来。人类应该在正确的时间、正确的抽象层级提供监督,而我们的系统设计应该考虑何时以及如何设置这样的触点。
结语
回到开头的类比。数学家用公理构建体系,工程师用分层构建系统。RSI 的本质,是让这个构建过程本身也成为可被优化的对象。
模型提供智能,Harness 提供运行时的系统能力。两者的共同进化,构成了 RSI 的完整图景。模型的进化依赖训练基础设施和架构创新的突破,Harness 的进化则已经有了一整套从上下文工程到进化搜索的方法论工具箱。而时空组合性等工程范式的出现,正在为 Harness 的安全热更新提供坚实的理论和工程基础。
对于行业实践者来说,关键的认知是:不要只关注模型能力的提升,同样要关注 Harness 的系统性建设和自动化优化。前者我们主要依赖基础模型厂商的持续突破,后者则是每个企业可以主动投入、构建竞争壁垒的领域。
智能的提升不是单点突破,而是系统工程。在这个系统中,每一层、每一个模块、每一个环节,都有机会被做得更好。而这个"做得更好"的过程本身,正在变得越来越自动化。
参考文献
1. Weng, Lilian. "Harness Engineering for Self-Improvement." Lil'Log, Jul 2026.
2. Ren et al. "Self-Improvements in Modern Agentic Systems: A Survey." arXiv:2607.13104, 2026.
3. Shi, Zhang, Cui. "A Programming Paradigm for Spatiotemporal Composability." Peking University & DeepSeek-AI, 2026.
4. Good, I. J. "Speculations Concerning the First Ultraintelligent Machine." Advances in Computers, 6:31–88, 1965.
5. Zelikman et al. "Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation." COLM 2024.
6. Zhang et al. "Self-Harness: Harnesses That Improve Themselves." arXiv:2606.09498, 2026.
7. Lin et al. "Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses." arXiv:2604.25850, 2026.
8. Hu, Lu, and Clune. "Automated Design of Agentic Systems." ICLR 2025.
9. Zhang et al. "AFlow: Automating Agentic Workflow Generation." ICLR 2025.
10. Zhang et al. "Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents." arXiv:2505.22954, 2025.
11. Novikov et al. "AlphaEvolve: A coding agent for scientific and algorithmic discovery." arXiv:2506.13131, 2025.
12. Hebbar et al. "SIA: Self Improving AI with Harness & Weight Updates." arXiv:2605.27276, 2026.
13. DeepSeek-AI. "DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence." arXiv:2606.19348, 2026.
14. Kimi Team. "Kimi K3: Open Frontier Intelligence." arXiv:2607.24653, 2026.